
摘要
AI 辅助构建任务,可以提供当前受评智能体尚未完成的可执行挑战,为后续改进提供具体资源。Recursive-Play 以 150 个交互式谜题环境实现这一想法,覆盖十类机制,每个任务包含六个连续关卡。仅供任务作者使用的构造性解答与确定性状态验证器用于确认关卡可达;参与测试的智能体只接收像素画面和中性控制,不获得规则或解答。在十一种配置、1,650 个独立符合纳入条件的评估结果中,按固定的 512 次动作 / 720 秒协议,仍有 15 个任务未被任何配置完整完成,其中两个任务没有任何配置通过哪怕一个关卡。
研究内容
- 独立回放验证了全部 900 个标准种子与关卡组合的构造性解答,均在动作预算内完成。
- 每个新回合使用原始模型标识、标准种子与盲测提示,六个关卡共用 512 次计费动作和 720 秒。部分进展单独计入并报告,与完整通过六个关卡的胜利区分。
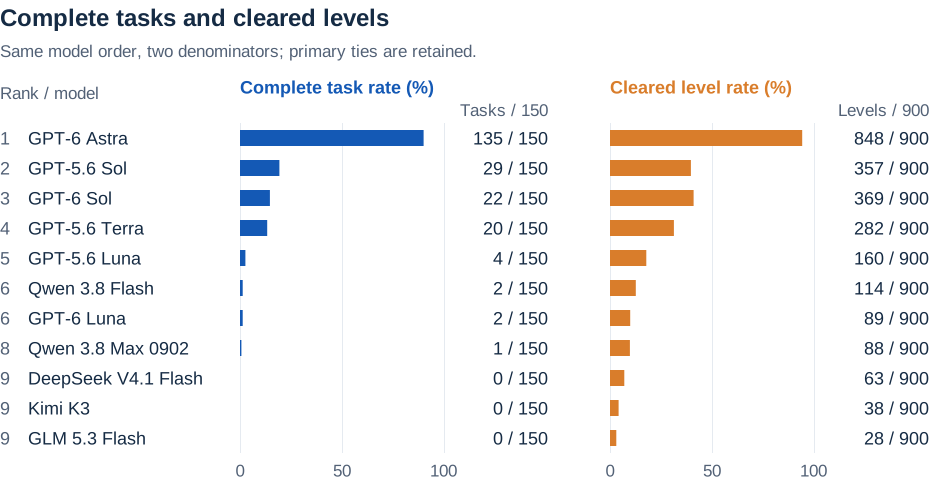
- 已观察到的最强配置完成 150 个任务中的 135 个;其余 15 个任务在记录的预算与设置下,十一种配置均未完整完成。
- 论文提出后续改进循环:选择经验证的失败,获取修正轨迹,训练候选模型,再以新冻结的留出任务和防退化检查进行测试。
基准概况
- 环境
- 150 个任务共包含 900 个关卡
- 评估配置数
- 11
- 预算
- 每个任务限用 512 次动作和 720 秒
- 所有配置均未完成
- 15 个任务
评分方式
- 每种配置从标准种子出发,每个任务运行一次,使用盲测提示:只提供像素画面与中性控制,不提供规则或解答。
- 在 512 次计费动作和 720 秒内通过全部六个关卡,才计为完整完成任务;部分进展以已通过关卡数单独报告。
- 分数来自已发布的 1,650 个独立符合纳入条件的回合最终汇总;同分并列。
环境
150 个交互式环境,配备确定性状态验证器与经过回放的构造性解答;源模块、任务记录和每个回合的结果均已发布。
范围与证据
仍待探索的问题
本研究建立了挑战供给与评估基础,训练能否带来改进仍待检验。本次发布没有展示训练带来的提升、持续适应或递归自我改进,已公开的任务库也不属于封存的留出测试集。
引用本研究
@misc{envloop_recursive_play,
  title  = {Recursive-Play: AI-Generated Interactive Challenges for Improving AI Agents},
  author = {{EnvLoop Research}},
  url    = {https://huggingface.co/datasets/EnvLoop/Recursive-Play-Bench}
}