
摘要
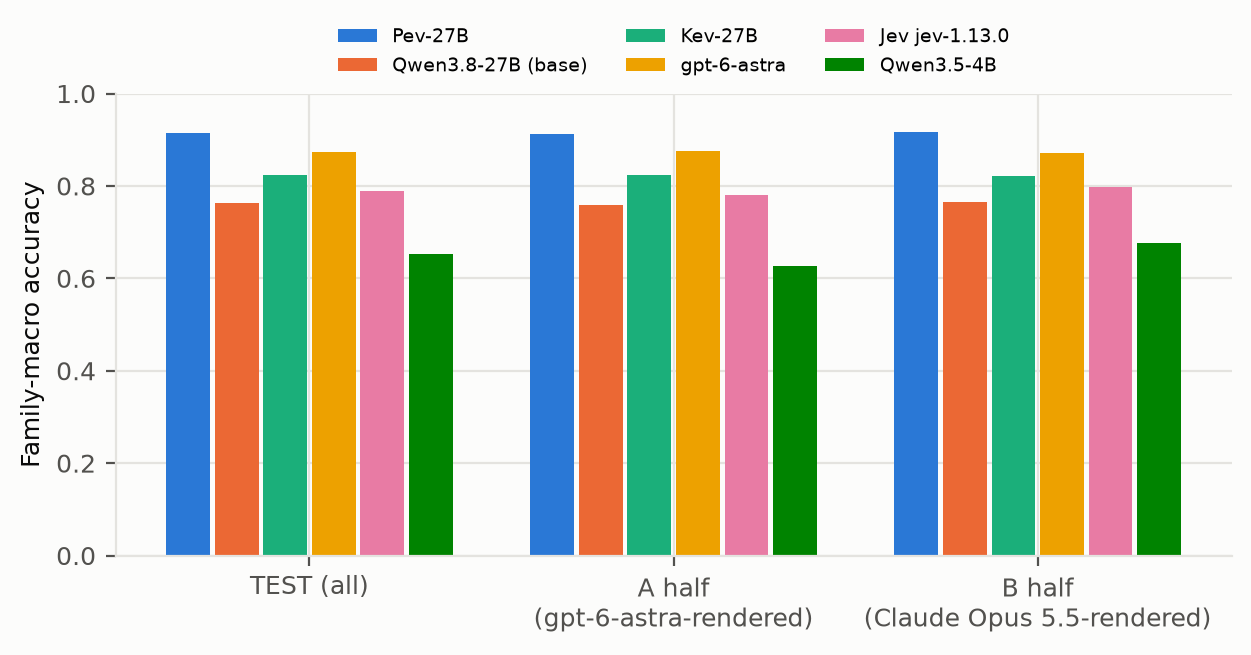
个人智能体会长期记住一位用户,并代表用户处理购物、出行、邮件与日程,正逐渐成为一种产品形态。它们的瓶颈往往在个人判断:每次请求中,都要多次判断这位具体用户会希望怎样处理。例如,用户要求“再买一次狗粮”,智能体需要推断用户因过敏更换过品牌、新品牌每袋 $54 已超过用户设定的 $50 免审批额度、用户要求遗忘的地址不能再次使用,以及这件事是否值得打断用户。我们将这些判断归纳为七类有明确类型的问题,训练出快速决策模型 Pev-27B,单次前向传播即可输出经过校准的选项概率;同时发布 Pev-Bench,基于真实公开行为构建,且不同数据划分之间的用户互不重叠。在包含 720 位新用户的公开测试集上,Pev-27B 的类别宏平均准确率达到 0.915,高于 gpt-6-astra(0.873)、Kev-27B(0.823)、Jev(0.788)及其基座模型(0.762)。
报告结果
| 模型 | 类别宏平均准确率 |
|---|---|
| Pev-27B | 0.915 |
| gpt-6-astra | 0.873 |
| Kev-27B | 0.823 |
| Jev | 0.788 |
| Qwen3.8-27B (base) | 0.762 |
研究内容
- Pev-27B 基于 Qwen/Qwen3.8-27B,采用 rank-16 LoRA,以单个选项标签 token 进行监督,并读取为选项上的温度校准概率分布。
- Pev-Bench 基于真实公开行为(Amazon Reviews 2023、UCSD Google Local)与真实干扰文本(Enron、OpenFlights)生成。文本渲染前由知识库固定标签,精确平衡标签与答案位置,逐字核对锚点,不同数据划分之间的用户互不重叠。
- 在预注册协议下,冻结模型通过了仅允许一次尝试的隐藏门槛测试:类别宏平均准确率从 0.754 提升到 0.905(+15.1 个百分点,95% CI [+13.5, +16.8]),安全假阴性减少;在 5% 错误预算内可独立回答的题目比例从 0.54 提升到 0.93。
- 公开测试集覆盖 720 位新用户,一半由 gpt-6-astra 渲染,另一半由 Claude Opus 5.5 渲染。Pev-27B 在总体与两个子集上均领先(每项比较经 Holm 校正后 p = 5 × 10⁻⁴)。
基准概况
- 测试用户
- 来自 720 位新用户的 980 个状态
- 评分题目
- 2,506 题中有 2,156 题参与评分
- 决策类别
- 7
- 数据划分
- 数据划分为训练集、验证集、开发集和测试集。
各决策类别的准确率
左右滑动,比较完整评分。
| 模型 | 选项选择 ↑ | 通知级别 ↑ | 审批需求 ↑ | 共享许可 ↑ | 遗忘约束 ↑ | 记忆应用 ↑ | 请求路由 ↑ |
|---|---|---|---|---|---|---|---|
| Pev-27B微调模型(基于 Qwen3.8-27B 的 LoRA) | 0.480 | 0.955 | 0.993 | 0.990 | 0.997 | 1.000 | 0.988 |
| gpt-6-astraAPI 模型 | 0.443 | 0.799 | 0.993 | 1.000 | 0.993 | 0.977 | 0.909 |
| Kev-27B第三方决策模型 | 0.433 | 0.575 | 0.893 | 0.977 | 0.997 | 0.977 | 0.909 |
| Jev第三方决策模型(TypeSafe) | 0.413 | 0.518 | 0.883 | 0.875 | 0.997 | 0.957 | 0.876 |
| Qwen3.8-27B开放权重基座模型 | 0.430 | 0.492 | 0.819 | 0.868 | 0.967 | 0.844 | 0.917 |
| Qwen3.5-4B开放权重基座模型 | 0.450 | 0.575 | 0.628 | 0.653 | 0.711 | 0.758 | 0.791 |
评分方式
- 每个模型在冻结权重与提示下,对每道 TEST 题目作答一次;得分为类别宏平均准确率,即七类准确率的非加权平均值。
- TEST 集分为由不同 LLM 渲染的两半(TEST-A 由 gpt-6-astra 渲染,TEST-B 由 Claude Opus 5.5 渲染),以便发现渲染模型对自身的潜在偏向。
- 软标签出现并列的题目没有唯一正确答案,不参与准确率评分。对提供概率输出的模型,Brier 与 ECE 使用温度校准后的概率计算。
- 这些结果使用基准发布的 Harbor 任务验证器,对冻结的预测结果重新评分,复现了论文中每个模型的数值。
环境
每个用户状态对应一个 Harbor 任务:智能体读取上下文与问题,写入 answers.json;无需联网的验证器返回准确率和逐题报告。训练集、验证集、开发集与测试集共包含 3,885 个任务。
范围与证据
仍待探索的问题
所有模型都尚未解决根据真实行为预测用户具体选择的问题;在两个类别中,gpt-6-astra 的安全假阴性仍略少。
引用本研究
@techreport{envloop_pev,
  title       = {Pev: A Calibrated Fast-Decision Model for Personal Agents},
  author      = {{EnvLoop Research}},
  institution = {EnvLoop},
  url         = {https://github.com/EnvLoop/Pev}
}