
摘要
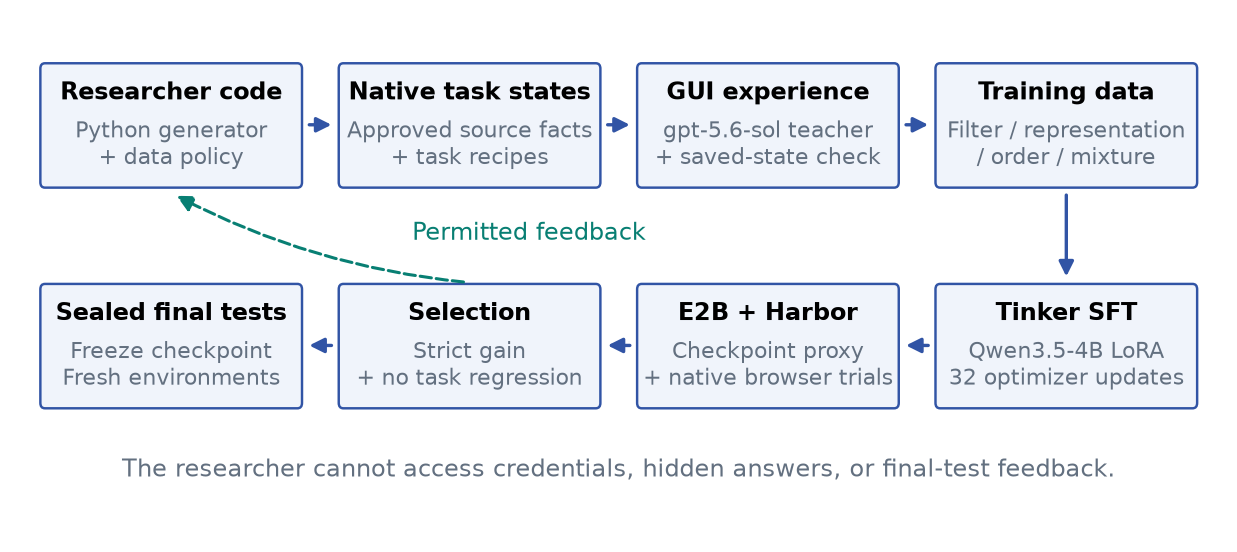
研究智能体能否把浏览器智能体的失败转化为更好的训练数据?CUA-RSIBench 是一项面向可验证计算机操作、以数据为中心的受控研究试验。前沿研究模型编写 Python 数据工厂,根据公开 issue 元数据在真实 Kanboard 应用中构建原生任务状态,向固定的 gpt-5.6-sol 教师模型采集经独立验证的 GUI 演示,再根据筛选反馈修订数据集。每个有效候选方案都通过 EnvLoop 训练一个全新的 Qwen3.5-4B LoRA 适配器,由 Harbor 在 E2B 中使用独立的保存状态验证器评估学生模型。在单独开展的 gpt-6-sol / gpt-6-luna 扩展试验中,gpt-6-sol 选出的学生模型在两轮、每轮六个任务的测试中获得 2/12(16.7%),基座学生模型为 0/12。
研究内容
- 两个独立实验组:原始组(gpt-6-astra、gpt-5.6-sol)完成 10 轮研究和 7 个候选训练;扩展组(gpt-6-sol、gpt-6-luna)完成 10 轮研究和 6 个候选训练。
- 每组各自使用封存的最终实例评估选出的学生模型。得分、训练资源、无效提交和基础设施故障均按实验组分别报告,不合并为四模型排名。
- 单独的 v0.6 验证说明记录了六个真实软件应用单元的环境与验证器工作,报告的是资格验证证据,并非完整研究结果。
范围与证据
仍待探索的问题
这是一项小规模的数据研究试验,不能据此认定已实现持续的递归自我改进或广泛的计算机操作泛化。试验仅涉及一个应用,并使用 DOM 辅助的浏览器操作。
引用本研究
@techreport{envloop_cua_rsibench,
  title       = {CUA-RSIBench: Executable Data Research for Verifiable Computer Use},
  author      = {{EnvLoop}},
  institution = {EnvLoop},
  url         = {https://github.com/EnvLoop/cua-rsibench}
}